

能力与用途
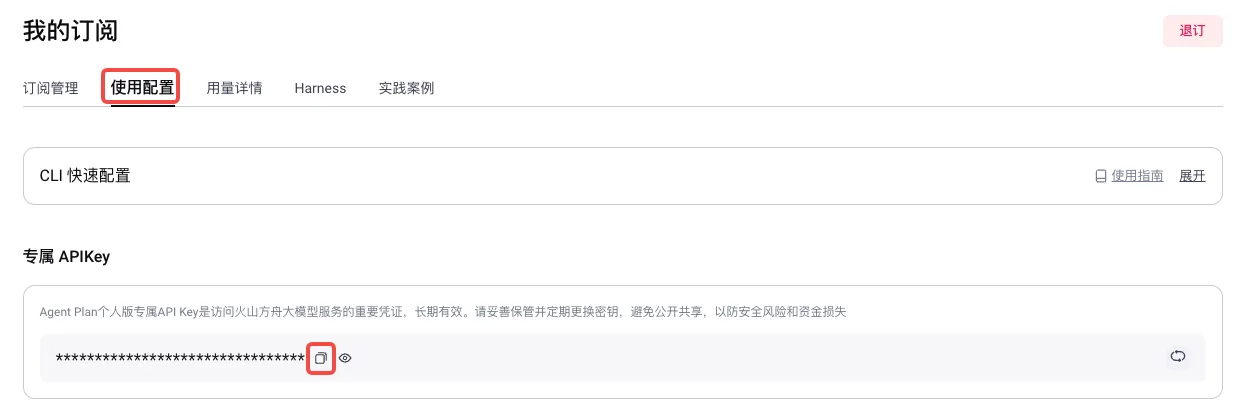
接入前提:需要火山方舟 Agent Plan 的专属 API Key;流式语音合成接口中 X-Api-Resource-Id 配置为 seed-tts-2.0。 接口选择(来自官方文档的接口表): - 双流接口:WebSocket,wss://openspeech.bytedance.com/api/v3/plan/tts/bidirection,支持流式发送文本、流式接收音频,适合实时对话等低延迟场景。 - 单流接口:WebSocket,wss://openspeech.bytedance.com/api/v3/plan/tts/unidirectional/stream,一次性发送全部文本、流式接收音频片段,适合长文本播报。 - HTTP 接口:HTTP POST https://openspeech.bytedance.com/api/v3/plan/tts/unidirectional,一次性返回完整音频,适合简单场景或非实时调用。 参数与输出:示例代码使用 req_params 中的 speaker(如 zh_female_gaolengyujie_uranus_bigtts、zh_female_vv_uranus_bigtts)与 audio_params(format=mp3,sample_rate=24000)。双流示例逐字符发送、字符间隔 5ms,可返回 usage 用量信息(需设置 X-Control-Require-Usage-Tokens-Return)。 集成注意:运行双流、单流示例前需先获取官方提供的 protocols.py 封装文件;计费按套餐内 AFP 抵扣规则与超额后付费规则执行,具体价格口径需查官方计费文档。 同一页面还提供豆包流式语音识别模型2.0(doubao-seed-asr-2.0,Resource-Id 为 volc.seedasr.sauc.duration),本条记录仅整理 TTS 模型。
暂无经过核验的逐项评分,暂不绘制能力雷达或综合排名。
数据与来源
- 资料提供方
- 火山方舟(字节跳动)
- 官方说明
- 核对官方资料 ↗
- 站内资料更新
- 2026-11-20 02:09:46
站内更新时间不等同于模型发布日期。未提供测试集、日期和原始成绩时,不展示官方或平台实测分数。
版本记录
历史版本、上线与下线日期待核实。
接入与使用
请按官方文档确认 API 地址、模型标识、身份验证、权限与收费规则。
打开官方文档